サーベイの自由記述をAIで分析する方法|ChatGPTに貼る前の匿名化と、分類がぶれない手順
経営への報告会まで2週間。今回のサーベイの自由記述は420件あり、昨年は担当者2人が3日かけて読み、Excelで色分けした。今年は上司から「ChatGPTに貼れば一瞬でしょう」と言われたものの、社員が書いた文章をそのまま貼ってよいのか、出てきた分類を報告に載せてよいのかが分からない。
数値の集計はサーベイツールが出してくれても、自由記述は人が読むしかなく、そのぶん報告までの期間が延びます。
リデザインワークがサーベイ活用支援の相談で伺った、従業員1,000名を超える企業の人事担当者の話では、これまでのサーベイはデータの収集から分析の報告までに2か月かかり、運用の負荷が高いとのことでした。
生成AIを使えば、読む時間は確かに縮みます。三菱総合研究所が住民アンケートの自由記述で試した結果では、研究員が約30分かけた100件の分類を、生成AIは約2分で終えている(三菱総合研究所、2024年)。
ただし同じ試行で、AIの分類が調査の実施者による分類と一致した割合は、最もよい条件でも67%でした。AIに貼れば速くなる一方、そのままでは報告に載せられない。差を埋めるのは、貼る前の準備と貼った後の確認です。
この記事を読み終えると、次のサーベイの自由記述を、匿名化から分類・件数・引用の選定まで、根拠を説明できる手順で報告資料にまとめられます。分析で行う作業、AIに貼るだけでは足りない理由、匿名化、分類表、指示文、人の確認、引用の選び方の順に説明する。
記事の後半には、AIへの指示文を3つ載せました。回答を貼ると、分類表の案、意見ごとの分類の一覧、分類ごとの要約と引用の候補が順に出ます。数値の結果も含めた分析の全体の流れは、エンゲージメントサーベイの分析方法で6つのステップに整理しています。
サーベイの自由記述分析は分類・集計・引用の3つの作業
手順に入る前に、自由記述の分析で何を作るのかを決めておきます。読むだけで終えると、報告資料に何を載せるかが決まらないためです。
サーベイの自由記述分析とは、回答を話題ごとに分類し、話題ごとの件数を数え、報告に載せる原文を選ぶ作業です。読んだ感想をまとめる作業とは違う。エンゲージメントサーベイに限らず、研修後や制度改定時の社員アンケートの自由記述にも、同じ手順を使えます。
| 作業 | 中身 | 人だけで行うときの手間 | AIに任せられる範囲 |
|---|---|---|---|
| 分類 | 回答を意見ごとに区切り、決めた分類に振り分ける | 全件を読む時間。読む人で振り分けが変わる | 区切りと振り分けの案を出す |
| 集計 | 分類ごとの件数を数え、部署や層の集計と並べる | 件数の数え直し | 一覧の作成。件数は表計算ソフトで数える |
| 引用 | 報告に載せる原文を選び、特定されない文面に直す | 代表的な声を探す時間 | 候補を挙げる。決めるのは人 |
分類の手段には、人が全件読む方法のほかに、単語の出現回数を数えるテキストマイニングと、文の意味で分類する生成AIがあります。テキストマイニングでは、「評価に納得している」と「評価されない」が同じ「評価」として数えられてしまう。意味の違いで分けたい自由記述には、生成AIが向いています。
件数の目安は、読む時間から決められます。三菱総合研究所の試行では、人が1,000件規模を分析すると4〜5時間程度かかるとされている。仮に50件なら15分前後で、匿名化と分類表の準備のほうが長くなります。数十件なら人が全件読み、数百件を超えたらAIに任せるのが現実的です。
自由記述の分類で分かるのは、何が書かれているかと、その件数までです。どの部署や層で点数が低いかは、数値の分析でしか分からない。2つを並べて初めて、点数の低い部署で何が起きているかを説明できます。
数値の分析で差が出る部署や層と、総合スコアに影響している設問を見つける6つの方法を、実データの図とあわせて解説したのが、資料『組織課題が分かるサーベイの分析方法6選』です。
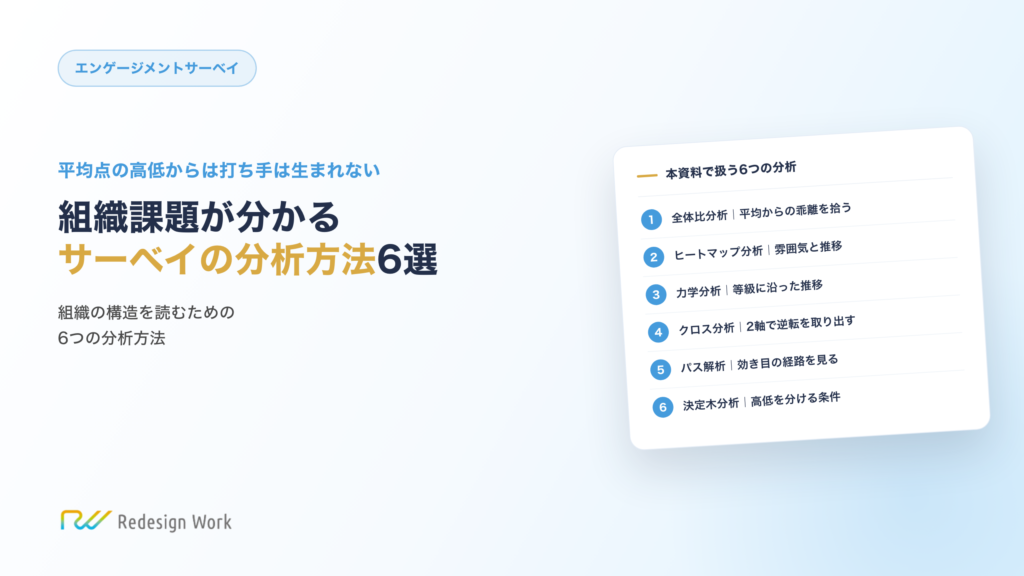
全社平均3.67、前回比プラス0.10。数字は出したのに、次に何をするかが決まらない。平均点の高低には打ち手の手がかりが無いからです。サーベイ担当が押さえるべき6つの分析方法を、実データの図とあわせて解説します。
サーベイの自由記述をAIに貼るだけでは報告に使えない3つの理由
作業の中身が決まったところで、AIに任せた場合を考えます。自由記述をそのままChatGPTやCopilotに貼り、「分類して要約して」と頼むと、それらしい一覧はすぐに出る。ところが、その一覧を報告に載せようとすると、次の3つで手が止まります。
理由1 分類の定義を渡さないとAIの分類が毎回変わる
1つ目は、分類の基準がAI任せになることです。「残業が多いのに、上司に相談しても何も変わらない」という1件を、AIが1回目は業務量、2回目は上司との関係に分ける。分類名もAIが毎回作るため、昨年の結果とも比べられません。
前述の三菱総合研究所の試行では、分類ごとの説明を詳しく書いた指示で一致率が上がりました。指示の書き方による差は、AIのモデルの違いによる差と比べても大きかったと報告されています。分類どうしの意味が重なっている場合には、AIでも誤りが多くなりました。
分類の精度は、使うAIの種類よりも、分類の定義を含む指示の書き方で大きく変わる。定義を渡さずに貼ると、毎回違う基準で分類されます。
理由2 1件の回答に複数の話題が書かれている
2つ目は、自由記述の1件が1つの話題とは限らないことです。「評価の基準が分からない。それと会議が多すぎて自分の仕事が進まない」という回答には、評価と業務量の2つが入っています。1件に1つの分類しか付けなければ、どちらかが件数から消える。
筑波大学の研究では、新型コロナに関する不満を聞いた自由記述から1,040件を取り出し、人の手で意見ごとに分けると、意見の数は1,716になりました(銭本ほか、言語処理学会 第30回年次大会、2024年)。回答の数で数えると、2つ目以降の意見は数に入りません。
理由3 氏名を消しても書いた人が特定できる
3つ目は匿名化の不足です。氏名と社員番号を消しても、「4月に営業から異動してきて、前の部署とのやり方の違いに戸惑っている」と書かれていれば、部署と時期から本人が分かることがある。
個人情報保護法は、氏名などで特定の個人を識別できる情報に「他の情報と容易に照合することができ、それにより特定の個人を識別することができることとなるものを含む」と定めています(個人情報保護法第2条第1項第1号)。氏名を消すだけでは、自由記述は匿名になりません。
3つの理由には、対策が1つずつ対応します。理由3の特定のおそれには匿名化、理由1の分類の揺れには分類表、理由2の複数の話題には意見ごとの区切りで対応する。
ChatGPT・Copilotに渡す前にサーベイの自由記述を匿名化する手順
3つの理由のうち、最初に手を打つのは3つ目の特定のおそれです。分類の誤りは後から直せますが、一度入力した文章は取り消せないためです。
まず確認するのは入力先のサービスです。個人情報保護委員会は2023年6月2日の注意喚起で、個人情報を含むプロンプトは利用目的の達成に必要な範囲内かを十分に確認するよう求めました(生成AIサービスの利用に関する注意喚起等)。
本人の同意なく個人データを入力する場合は、サービスの提供者が機械学習に利用しないこと等を十分に確認する必要がある、とも書かれている。
たとえば組織のアカウントで使うMicrosoft 365 Copilot Chat(2026年にMicrosoft Copilot Chatへ名称変更)は、プロンプトと応答が基礎モデルのトレーニングに使用されないと公式に説明されています(Microsoft Learn)。
ChatGPTを使う場合も、会社が契約した法人向けの環境か、入力した内容が学習に使われない設定かを、情報システム部門に確認します。
あわせて、サーベイの案内で回答者に伝えた利用目的も読み返します。「組織の改善のために集計・分析する」と伝えているなら、AIによる分類がその範囲に入るかを確認しておく。人事のデータで入力してよい範囲の決め方は、人事部の生成AI導入で扱っています。
入力先が決まったら、データから消す情報と置き換える情報を分けます。
| 情報 | 例 | 扱い |
|---|---|---|
| 回答者の識別子 | 氏名・社員番号・メールアドレス | AIに渡すデータから外し、回答IDだけを残す |
| 文中の人名 | 「田中課長が」 | 「上司A」などに置き換える |
| 部署名・拠点名・顧客名 | 「〇〇支店では」「△△社の案件で」 | 「拠点」「担当顧客」などに置き換える |
| 属性の列 | 部署・役職・年代・勤続年数 | AIに渡さず、分類が終わった後に回答IDで結合する |
| 本人が分かる出来事 | 異動・休職からの復帰・社内に1人だけの役割 | 出来事の種類だけを残して書き換える |
人名の置き換えは、社員名簿の氏名の列を使い、表計算ソフトの置換で一括して行います。人名を探す作業をAIに頼むと、置き換える前の文章をAIに入力することになるからです。
出来事の書き換えは、担当者が全件に目を通して行います。確認する観点は「この文で書いた人が分かるか」の1つだけ。
属性を後から結合するのは、AIに部署と本文を同時に渡さないためです。それでも少人数の部署は、結合した後の集計で特定されることがあります。属性を掛け合わせたときの人数の下限は、サーベイのクロス集計で整理しています。
サーベイの自由記述を分類する前にAIに渡す分類表を作る
匿名化したデータが用意できたら、次はAIに渡す分類の定義を作ります。理由1の、分類が毎回変わる問題を防ぐためです。
分類表とは、分類ごとに名前・含める内容・含めない内容を書いた表を指します。名前は数値の設問カテゴリと同じにしておく。上司との関係の点数が低い部署で、上司についての自由記述が何件あるかを並べられるからです。
| 分類 | 含める内容 | 含めない内容 |
|---|---|---|
| 業務量と時間 | 残業の多さ・人手不足・会議や報告の多さ | 上司の指示の出し方への不満(上司との関係へ) |
| 上司との関係 | 相談のしやすさ・指示や支援の内容・面談の頻度 | 評価の結果への不満(評価と処遇へ) |
| 評価と処遇 | 評価基準の分かりにくさ・評価の結果・給与と昇格 | 研修の機会(成長とキャリアへ) |
| 成長とキャリア | 研修・任される仕事・異動の希望 | 会社の事業の方向(会社の方針へ) |
| 会社の方針 | 経営の方針・事業の方向・説明の不足 | 自部署の目標の決め方(上司との関係へ) |
| その他 | どの分類にも当てはまらない意見 | ― |
含めない内容の列が、分類どうしの重なりを防ぎます。理由1で見た、意味の重なる分類で誤りが増える問題への対策です。上の表は分類を5つに絞った例で、実際には、その他を含めて7〜10個に収めると件数の比較が読みやすくなる。
前述の試行では、回答の例をいくつか添えても一致率は上がりませんでした。例を足すより、含める内容と含めない内容を言葉で書くほうが、分類の基準は伝わります。
理由2の複数の話題には、分類の前に意見ごとに区切る指示で対応します。1件に2つの話題があれば2行に分け、それぞれに分類を付ける。件数は回答の数ではなく、意見の数で数えます。
分類表の最初の案は、匿名化した回答から100件ほどを無作為に抜き、次の指示文で作らせます。設問カテゴリの一覧は、自社のサーベイの数値の設問のものを貼ってください。
あなたは従業員サーベイの分析担当者です。
以下は、匿名化済みのサーベイの自由記述から無作為に抜き出した回答です。
これを読み、全件の分類に使う分類表の案を作ってください。

【数値の設問カテゴリ】
(例:業務量と時間、上司との関係、評価と処遇、成長とキャリア、会社の方針)

【回答】
(回答IDと本文を1行1件で貼り付け)

【出力】
1. 分類表:分類名・含める内容・含めない内容(回す先の分類を括弧で書く)の3列
   分類名はできるだけ設問カテゴリと同じにし、最後に「その他」を置く。全部で7〜10個
2. 判断に迷った回答:迷った2つの分類と理由を、回答IDつきで5件まで
3. 設問カテゴリにない話題で、5件以上書かれていたもの

【注意】
・回答に書かれていない内容を推測で補わない
出力の2つ目にある迷った回答は、含めない内容の列を直す材料です。扱いを決めて表に書き足してから、全件の分類に進みます。
サーベイの自由記述をAIで分類・集計する手順と指示文
分類表が決まれば、全件の分類に進めます。手順は次の5つです。
- データを2列にする 匿名化した回答を、回答IDと本文の2列にする
- 分類表と一緒に貼る 下の指示文で、意見ごとの一覧を表で出させる
- 件数は表計算ソフトで数える AIが文章で書いた件数は使わない
- 属性を結合する 回答IDで部署や層の列を結合し、部署ごとの件数を出す
- 分類ごとに要約させる 分類済みの一覧を2つ目の指示文に貼る
あなたは従業員サーベイの分析担当者です。
以下の【分類表】に従って、【回答】を分類してください。

【分類表】
(分類名・含める内容・含めない内容の表を貼り付け)

【回答】
(回答IDと本文を1行1件で貼り付け。匿名化済み)

【手順】
1. 1件に複数の話題があれば、話題ごとに行を分ける
2. 意見ごとに分類表から主分類を1つ選ぶ。迷う場合は副分類も1つ選ぶ
3. 肯定・否定・要望のどれかを判定する
4. ハラスメントの訴え・心身の不調・安全上の問題・法令違反のおそれには「要対応」と書く

【出力】
回答ID・意見(原文の該当部分をそのまま)・主分類・副分類・肯定否定要望・要対応の6列の表
表以外の文章は書かない。全件を省略せずに出力する

【注意】
・分類表にない分類名を作らない。当てはまらなければ「その他」とする
一度に貼れる量には上限があります。出力の表が途中で切れたら、回答IDの範囲で分けて同じ分類表で処理し、結果を1つの表にまとめる。
件数を数え終えたら、分類ごとの要約と引用の候補を出させます。
以下は、サーベイの自由記述を分類した一覧です。
分類ごとに、次の3点をまとめてください。

【一覧】
(回答ID・意見・主分類・副分類・肯定否定要望・要対応の表を貼り付け)

【出力】
1. 分類ごとの要約:3行以内。各行に根拠の回答IDを添える
2. 引用の候補:分類ごとに主張の異なる意見を3件。回答IDと原文のまま
3. 件数は少ないが内容が深刻な意見:回答IDつきで

【注意】
・一覧にない内容を書かない。件数は文章で書かない
要約の各行に回答IDを付けさせるのは、後の確認で原文と照合するためです。
AIによる自由記述の分類を人が確認する4つの手順
AIの一覧をそのまま報告に載せないのは、冒頭で見た一致率の結果があるからです。最もよい条件でも、3件に1件はAIと実施者の分類が食い違っていました。
一方で同じ試行では、調査の設計に関わっていない研究員2名による分類の一致率が、最もよい条件のAIを下回りました。人が分類しても基準は揺れる。確認の目的は、AIの誤りを探すことより、分類表どおりに分かれているかを確かめることにあります。
| 手順 | 対象 | 何をするか |
|---|---|---|
| 1 一致を数える | 無作為に選んだ50件 | 担当者が同じ分類表で分類し、AIの主分類と一致した件数を数える |
| 2 分類表を直す | 一致しなかった件 | どの分類の定義が曖昧だったかを特定し、含める内容と含めない内容を書き直す |
| 3 全件を読む | 要対応の印が付いた件と、その他に入った件 | 担当者が原文を読み、扱いを決める |
| 4 原文と照合する | 要約の各行と、報告に載せる引用 | 回答IDで原文を開き、要約が原文と合っているかを確認する |
2つ目の手順で分類表を直したら、全件をもう一度分類させます。三菱総合研究所の報告も、読む手間のかからない生成AIは分類の区分を何度でも変更できる点を利点に挙げている。
3つ目の要対応の件は、件数が少なくても全件を担当者が読みます。ハラスメントの訴えは1件でも対応が必要で、AIの要約では少数の意見が省かれることがあるためです。
肯定か否定かの判定も、同じ50件で一致を数えます。前半で褒めて後半で不満を書く回答は、判定が分かれやすいためです。
サーベイの自由記述の引用は数値の結果に合わせて選ぶ
確認が終わった一覧から、報告に載せる引用を選びます。件数の多い分類から並べると、今回の論点と関係のない声が報告の大半を占めることがある。
引用は、数値の分析で点数が低かった領域の分類から選びます。数値で分かった「どこで」に、自由記述で「何が起きているか」を添える組み立てです。報告資料に載せる表の記入例を示します(件数と引用は架空の例)。
| 分類 | 意見の数 | 関連する数値の結果 | 引用(記入例) |
|---|---|---|---|
| 業務量と時間 | 68件(全意見の14%) | 業務量の設問で、入社3年目までの層が全体より低い | 「会議と報告書の作成で、本来の業務に手を付けるのが夕方になる」 |
| 上司との関係 | 41件(同8%) | 上司との関係の設問は全体と差がない | 「面談はあるが、相談した内容がその後どうなったか分からない」 |
選ぶときの決まりは4つです。
- 1つの分類から2〜3件 主張の違う意見を選び、肯定的な意見も入れる
- 件数を添える 分類ごとの意見の数と、全意見に対する割合を書く。意見の数は回答者の数と違うことを注記する
- 文面を直したら注記する 特定につながる語を除いた場合は「一部表現を修正」と書く
- 少人数の部署の引用を載せない 部署名と引用を並べると、書いた人が分かることがある
設計から報告までの工程ごとの工数の測り方はエンゲージメントサーベイの運用工数で、自由記述の設問の数や聞き方はエンゲージメントサーベイの質問項目で扱っています。
なお、自由記述の分類表づくりや匿名化の手順は、リデザインワークのサーベイ活用支援でも無料でご相談を承っています。
サーベイの自由記述のAI分析は分類表を作った回から比較できる
AIで速くなるのは、自由記述を読む時間です。報告に使えるかどうかは、貼る前に作る分類表と、貼った後の確認で決まる。
分類表には、次の回にも使えるという利点があります。同じ分類表で翌年も分類すれば、業務量についての意見が何件から何件に変わったかを比べられる。AIに毎回分類名を作らせていると、この比較はできません。
まずは前回のサーベイの自由記述から100件を抜き、匿名化したうえで、分類表の案を作る指示文に貼ってみてください。迷った回答の扱いを決めれば、次の報告で使う分類表ができあがります。分類した意見から施策を選ぶ手順は、従業員エンゲージメント向上の施策12選で扱っています。